Insights · · 13 Min. Lesezeit · HYPED
Indexierungssteuerung im Onlineshop: Welche Seiten Google sehen soll
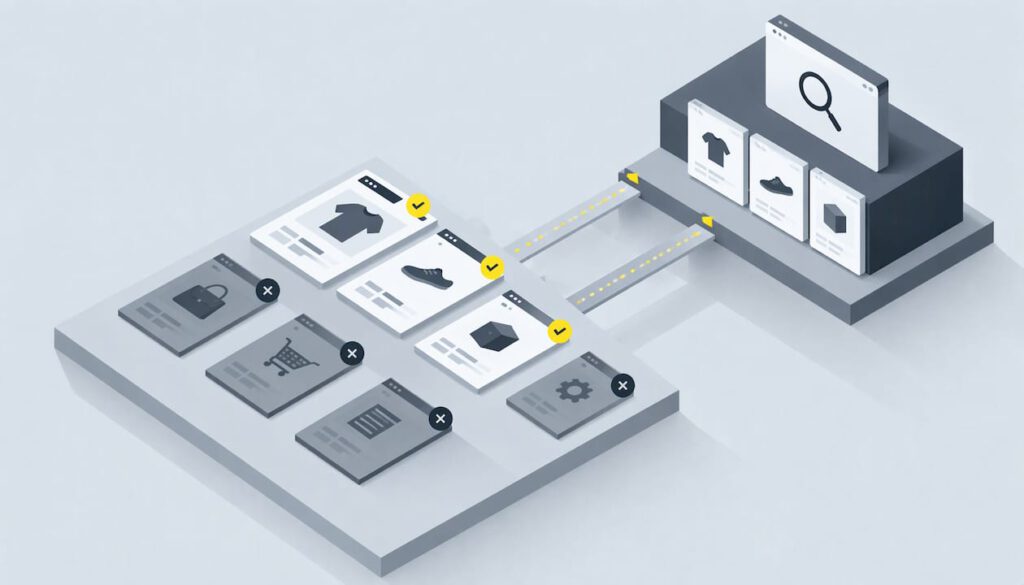
Mit Indexierungssteuerung legst du im Shop fest, welche URLs Google crawlen und in den Suchindex aufnehmen soll und welche nicht. Das Ziel ist nicht, dass möglichst viele Seiten indexiert werden. Es geht darum, dass Kategorien und Produkte, die Umsatz bringen, sauber im Index stehen, während Filterkombinationen, interne Suchergebnisse, Warenkorb und Duplikate draußen bleiben. Dafür gibt es vier Werkzeuge: robots.txt, noindex, Canonical-Tags und die XML-Sitemap. Schwierig wird es, weil diese Signale zusammenwirken und sich ein Shop jede Woche verändert. Deshalb ist Indexierungssteuerung keine einmalige Einstellung, sondern eine Routine. Am besten klappt sie, wenn jeden Monat jemand die Search-Console-Daten auswertet und dir sagt, was zuerst dran ist.
Kurz gesagt
- robots.txt steuert das Crawling, nicht den Index. Eine blockierte Seite kann trotzdem in den Suchergebnissen auftauchen. Wenn eine Seite nicht in den Index soll, nimmst du noindex.
- noindex wirkt nur, wenn Google die Seite crawlen darf. Setzt du noindex und sperrst die Seite zusätzlich per robots.txt, sieht Google die Anweisung nie.
- Filter, Varianten und Paginierung brauchen klare Regeln: eindeutige URLs, ein selbstverweisendes Canonical, keine leeren Filterseiten mit Statuscode 200.
- Die Search Console ist dein Kontrollinstrument. Im Bericht „Seiten“ siehst du, was indexiert ist und warum andere URLs fehlen.
- Zuerst kommen die Umsatzseiten, nicht 100 % Indexierung. Das ist die Reihenfolge, nach der wir jeden Monat priorisieren.
Inhaltsverzeichnis
- Warum ein Shop seine Indexierung aktiv steuern muss
- Die vier Werkzeuge und wofür sie taugen
- Welche Shopseiten in den Index gehören
- Schritt für Schritt: So steuerst du die Indexierung im Shop
- Was sich bei Googles Vorgaben geändert hat
- Wie lange Indexierung dauert und wie du Probleme findest
- Indexierung im Griff, ohne die Kontrolle abzugeben
- Unsere Sicht: Umsatzseiten zuerst
- Häufige Fragen zur Indexierung im Shop
- Quellen
Warum ein Shop seine Indexierung aktiv steuern muss
Ein Onlineshop erzeugt viel mehr URLs als eine Kanzlei- oder Praxis-Website. Aus jeder Kategorie mit fünf Filtern werden schnell Tausende Kombinationen, dazu kommen Sortierungen, Varianten, Sitzungsparameter und Tracking-Codes. Viele dieser URLs zeigen fast denselben Inhalt.
Das hat zwei Folgen. Erstens: Google erkennt erst nach dem Abruf beider URLs, dass sie identisch sind. Jede vermeidbare Duplikat-URL kostet also Crawling-Anfragen, die dann für neue Produkte oder geänderte Preise fehlen. Zweitens: Laut Google kann die Indexierung von Inhalten geringer Qualität dem Ranking der ganzen Website schaden. Hunderte dünne Filterseiten im Index sind darum kein harmloser Nebeneffekt.
Wie viele Seiten Google bei dir abruft, hängt vom Crawling-Budget ab. Google bestimmt es aus dem Crawling-Kapazitätslimit und dem Crawling-Bedarf, also daraus, wie viel dein Server verträgt und wie interessant Google deine Inhalte findet. Wann das Budget für deinen Shop wirklich zählt, erklären wir im Beitrag zum Crawl Budget im Shop.
Für Kanzleien, Praxen, Gutachter und Dienstleister mit wenigen Dutzend Seiten gelten dieselben Signale. Meist reicht dort aber eine saubere Sitemap und noindex für Danke-Seiten, Login-Bereiche und Rechtstexte ohne Suchwert.
Die vier Werkzeuge und wofür sie taugen
Die meisten Indexierungsfehler in Shops passieren, weil ein Werkzeug für eine Aufgabe genutzt wird, für die es nicht gemacht ist. Diese Übersicht zeigt, was jedes Signal kann.
| Werkzeug | Was es steuert | Wofür du es nutzt | Typischer Fehler |
|---|---|---|---|
| robots.txt | Crawling | Unwichtige URL-Muster wie Warenkorb, Sortierparameter oder Filterkombinationen gar nicht erst abrufen lassen | Seiten sperren, die eigentlich aus dem Index sollen |
| noindex (Meta-Tag oder X-Robots-Tag) | Indexierung | Einzelne Seiten aus den Suchergebnissen halten, etwa die interne Suche | noindex setzen und die Seite zusätzlich per robots.txt blockieren |
| Canonical-Tag | Bevorzugte Version bei Duplikaten | Varianten und Parameter-URLs auf die Haupt-URL bündeln | Canonical auf eine Seite mit noindex oder auf eine Weiterleitung |
| XML-Sitemap | Hinweis auf wichtige URLs | Alle indexierbaren Kategorien und Produkte melden | Gesperrte, weitergeleitete oder noindex-URLs in der Sitemap |
robots.txt: der Türsteher fürs Crawling
Die robots.txt ist eine Textdatei im Stammverzeichnis deiner Domain. Sie sagt Crawlern, welche Pfade sie nicht abrufen sollen. Google stellt klar, dass sie vor allem den Crawling-Traffic steuert: Eine blockierte URL kann ohne Beschreibung in den Suchergebnissen erscheinen, etwa wenn andere Seiten auf sie verlinken.
Für Seiten, die Google gar nicht abrufen soll, ist die robots.txt trotzdem das effizientere Signal. Bei noindex muss Google die Seite erst laden und auswerten. Das frei werdende Budget verteilt Google aber nur dann auf andere Seiten, wenn das Kapazitätslimit vorher erreicht war. Shopsysteme bringen oft schon eine Grundkonfiguration mit: Shopify zum Beispiel liefert jeden Shop mit einer vorkonfigurierten robots.txt.liquid-Vorlage aus, die unter anderem den Warenkorb vom Crawling ausschließt.
noindex: der zuverlässige Weg aus dem Index
Wenn eine Seite nicht in den Suchergebnissen erscheinen soll, empfiehlt Google das noindex-Meta-Tag oder den gleichwertigen HTTP-Header X-Robots-Tag. Den Header brauchst du für Dateien ohne HTML-Kopf, zum Beispiel PDFs. Die Bedingung dabei: Google entfernt die Seite nur, wenn sie nicht per robots.txt blockiert ist und für den Crawler zugänglich bleibt. Ein gesperrter Crawler kann das noindex nicht lesen.
Sie sehen gerade einen Platzhalterinhalt von Standard. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf den Button unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Canonical: welche Version zählt
Das Canonical-Tag im Seitenkopf zeigt Google, welche URL die Hauptversion eines Inhalts ist. Google behandelt es als starken Hinweis, nicht als Befehl. Im URL-Prüftool der Search Console siehst du, welche Version Google selbst als kanonisch gewählt hat. Weicht sie von deiner ab, widersprechen sich deine Signale meistens irgendwo.
XML-Sitemap: die Liste deiner wichtigen Seiten
In die Sitemap gehören nur URLs, die indexiert werden sollen. Pro Datei gelten laut Google höchstens 50.000 URLs oder 50 MB unkomprimiert, mit absoluten URLs in UTF-8-Codierung. Größere Shops teilen die Sitemap deshalb nach Kategorien, Produkten und Ratgeberseiten auf. Das hat einen Vorteil: Du siehst in der Search Console pro Seitentyp, wie viel davon indexiert ist. Das Einreichen bleibt ein Hinweis und garantiert kein Crawling.
Welche Shopseiten in den Index gehören
Die Grundregel lautet: Indexiert wird, was eine echte Suchanfrage besser beantwortet als jede andere Seite deines Shops. Für die typischen Seitentypen heißt das:
| Seitentyp | Empfehlung | Begründung |
|---|---|---|
| Kategorieseiten | indexieren, in die Sitemap | Sie ranken für die umsatzstarken Gattungsbegriffe |
| Produktseiten | indexieren, in die Sitemap | Sie fangen Suchen nach Marke, Modell und Artikelnummer ab |
| Produktvarianten mit optionalem Parameter | Canonical auf die Produkt-URL ohne Parameter | Bündelt Signale auf eine URL |
| Paginierte Kategorieseiten | eigene URL, selbstverweisendes Canonical | Produkte auf Seite 2 und weiter bleiben auffindbar |
| Filterkombinationen ohne Suchnachfrage | nicht crawlen lassen (robots.txt) | Spart Crawling für wichtige Seiten |
| Interne Suchergebnisse | noindex | Endlos viele dünne Seiten |
| Warenkorb, Checkout, Kundenkonto | per robots.txt sperren | Kein Inhalt für Suchende |
| Leere Kategorien | noindex, unter Umständen 404 | Keine Seite ohne Produkte im Index |
| Dauerhaft entfernte Produkte | 404 oder 410 | Google hört auf, sie abzurufen |
Filter und Facetten
Facettennavigation nennt man die Filterleiste mit Größe, Farbe, Marke oder Preis. Sie ist die größte URL-Quelle in fast jedem Shop. Google empfiehlt in seiner Dokumentation zum Crawling von Facettensuche-URLs, das übliche Trennzeichen & zu verwenden und auf Kommas, Semikolons und Klammern zu verzichten. Filterkombinationen ohne Ergebnisse sollen nicht als leere Seiten mit Statuscode 200 existieren. Der Statuscode 200 sagt Google „alles in Ordnung, hier ist Inhalt“, obwohl dort nichts steht.
In der Praxis entscheidest du pro Filter: Eine Kombination wie „Damen Laufschuhe wasserdicht“ hat Suchnachfrage und verdient eine eigene, indexierbare Seite mit Text. Die Kombination „Größe 38, Preis absteigend, Farbe Grau“ hat keine Nachfrage und bleibt für Crawler gesperrt. Wie du solche Landingpages ausbaust, zeigen wir im Artikel zur Kategorieseiten-SEO.

Varianten und Parameter
Für Produktvarianten empfiehlt Google eigene URLs. Ist der Variantenparameter optional, wird die parameterlose Produkt-URL zum Canonical. Parameter sollen dem Muster ?key=value folgen (also /t-shirt?color=green statt /t-shirt?green), nicht doppelt vorkommen und keine kurzlebigen Werte wie Sitzungs-IDs oder Tracking-Codes in internen Links enthalten.
Paginierung
Seite 2, 3 und 4 einer Kategorie bekommen eigene URLs und verweisen per Canonical auf sich selbst, nicht auf Seite 1. Sonst findet Google Produkte, die nur auf den hinteren Seiten verlinkt sind, schlechter. Zusätzlich sollte deine Paginierung keine URLs für Seiten erzeugen, die es gar nicht gibt, etwa Seite 40 bei nur 12 Seiten.
Schritt für Schritt: So steuerst du die Indexierung im Shop
-
Bestand aufnehmen. Öffne in der Search Console den Bericht „Seiten“. Er zeigt indexierte und nicht indexierte URLs mit den Gründen, etwa robots.txt-Regeln, noindex, Duplikate oder 404-Fehler. Wo es schiefgeht: Die Beispielliste ist auf 1.000 Einträge begrenzt, in großen Shops siehst du also nur einen Ausschnitt. Genau hier setzen wir an: Im Organic Growth System ist die Search Console angebunden, und unser Monatsreport ordnet die Ausschlussgründe nach ihrem Einfluss auf den Umsatz.
-
Seitentypen festlegen. Ordne jede URL-Gruppe einer Regel aus der Tabelle oben zu. Wo es schiefgeht: Teams diskutieren einzelne URLs statt Muster. Denk in Vorlagen und Parametern, dann reichen wenige Regeln für Tausende Seiten.
-
robots.txt bereinigen. Sperre Warenkorb, Checkout, Konto, Sortier- und Filterparameter ohne Suchnachfrage. Wo es schiefgeht: Eine einzige zu breite Regel wie „Disallow: /*?“ kann auch indexierbare Parameterseiten oder Varianten blockieren.
-
noindex gezielt setzen. Interne Suche, leere Kategorien, Danke-Seiten. In Shopify geht das zum Beispiel über eine Bedingung im theme.liquid-Layout. Wo es schiefgeht: noindex auf einer Seite, die gleichzeitig per robots.txt gesperrt ist, wirkt nicht.
-
Canonicals prüfen. Varianten zeigen auf die Haupt-URL, paginierte Seiten auf sich selbst. Wo es schiefgeht: Canonicals auf weitergeleitete oder auf noindex-Seiten senden widersprüchliche Signale.
-
Sitemap aufräumen und einreichen. Nur indexierbare URLs mit Statuscode 200, aufgeteilt nach Seitentyp. Den Sitemap-Pfad kannst du zusätzlich in die robots.txt eintragen.
-
Entfernte Produkte richtig beenden. Dauerhaft entfernte Seiten liefern 404 oder 410, Soft-404s (leere Seiten mit Status 200) werden beseitigt. So empfiehlt es Google in der Doku zum Crawling-Budget.
-
Monatlich kontrollieren. Neue Kategorien, Saisonfilter oder ein Theme-Update können alles wieder verschieben. Wo es schiefgeht: Niemand schaut nach, bis die Umsätze aus der organischen Suche fallen. Eine strukturierte Prüfung beschreiben wir im SEO-Audit für E-Commerce-Shops.
Was sich bei Googles Vorgaben geändert hat
Die Grundsätze sind stabil, einige Details aber nicht. Drei Änderungen solltest du kennen, weil ältere Anleitungen sie noch nicht berücksichtigen:
- Kein URL-Parameter-Tool mehr. Google hat das Parameter-Tool in der Search Console 2022 eingestellt und erkennt Parameter seitdem selbst. Parameter steuerst du heute also über saubere URLs, robots.txt und Canonicals im Shop.
- Eigene Doku zur Facettennavigation. Im Dezember 2024 hat Google seine früheren Empfehlungen zu Filter-URLs in eine eigene Dokumentationsseite überführt. Damit sind sie offizieller Maßstab für Shops.
- noindex und JavaScript. Im Dezember 2025 hat Google in der JavaScript-Doku klargestellt, wie der Crawler noindex auf JavaScript-Seiten behandelt. Für Shops mit JavaScript-Frontends heißt das: Steht noindex im ausgelieferten HTML, verlass dich nicht darauf, dass ein Skript es später wieder entfernt.
Außerdem kannst du heute in der Search Console verwalten, ob deine Inhalte für generative KI-Funktionen in der Google-Suche genutzt werden. Für Shops, die auch in KI-Antworten auftauchen wollen, gehört das zur Indexierungssteuerung dazu.
Wie lange Indexierung dauert und wie du Probleme findest
Laut Search-Console-Hilfe kann es etwa eine Woche dauern, bis Google eine neue Seite crawlt und indexiert. Für einzelne wichtige URLs kannst du im URL-Prüftool das Crawling anfordern. Dafür gibt es aber ein Kontingent, und wiederholte Anfragen beschleunigen nichts. Für viele URLs auf einmal ist die Sitemap der richtige Weg. Eine Anfrage garantiert keine Aufnahme in den Index.
Wenn eine Produktseite fehlt, prüfst du in dieser Reihenfolge:
- URL-Prüftool: Ist die Seite indexiert, und welche URL hält Google für kanonisch?
- robots.txt: Sperrt eine Regel versehentlich den Pfad?
- noindex: Steht im Quelltext oder im HTTP-Header ein noindex, zum Beispiel aus einer Theme-Einstellung?
- Duplikat: Hat Google eine Variante oder Parameter-URL als Hauptversion gewählt?
- Interne Links: Ist die Seite überhaupt aus einer Kategorie verlinkt?
Hast du ein Problem behoben und in der Search Console als beseitigt markiert, verschwindet es 90 Tage nach der letzten Instanz aus dem Bericht. Warum du dabei nicht 100 % Indexierung anstreben solltest, steht in unserem Beitrag zu SEO-Indexierungsproblemen.
Indexierung im Griff, ohne die Kontrolle abzugeben
Indexierungssteuerung ist Detailarbeit, die sich jeden Monat wiederholt: Bericht lesen, Muster erkennen, Regeln anpassen, Wirkung prüfen. Das Organic Growth System von HYPED kostet 379 € im Monat und ist monatlich kündbar. Es verbindet deine Search Console, liefert ein GEO-Audit, KI-Sichtbarkeits-Monitoring und jeden Monat einen Report mit priorisierten Handlungsempfehlungen. Dazu kommen bis zu 30 Artikel im Monat, die Menschen vor der Veröffentlichung prüfen.

Du behältst die volle Kontrolle, es gibt keinen Fremdzugriff auf deine Konten. Wenn du vorher sehen willst, wie Google und KI-Systeme deine Seite gerade sehen, starte mit dem kostenlosen Sichtbarkeits-Check.
Unsere Sicht: Umsatzseiten zuerst
In 13 Jahren E-Commerce und SEO haben wir gelernt, dass Indexierung kein technisches Häkchen ist, sondern eine Priorisierungsfrage. Ein Shop mit 40.000 indexierten URLs ist nicht stärker als einer mit 4.000, wenn die 4.000 die richtigen sind.
Deshalb fragen wir nie zuerst „Warum ist diese URL nicht im Index?“, sondern „Welche Seiten verdienen Geld, und stehen die sauber drin?“. Erst danach räumen wir Filter, Parameter und Duplikate auf.
Viele Shops setzen das selbst um oder haben eine Agentur dafür. Beides ist in Ordnung. Was oft fehlt, ist jemand, der jeden Monat mit frischem Blick auf die Daten schaut und klar sagt, was als Nächstes dran ist. Genau so verstehen wir uns: als Copilot für alle, die selbst umsetzen, und als Sparringspartner, wenn du eine Zweitmeinung zu deiner bestehenden Agentur brauchst. Dein Shop, deine Konten, deine Entscheidung, und wir liefern die Prioritäten.
Dominic
Häufige Fragen zur Indexierung im Shop
Soll ich Filterseiten per robots.txt oder per noindex ausschließen?
Filterkombinationen, die Google gar nicht abrufen soll, sperrst du per robots.txt, denn das spart Crawling. noindex nimmst du für Seiten, die Google crawlen darf, die aber nicht in den Suchergebnissen erscheinen sollen. Beides zusammen auf derselben URL funktioniert nicht, weil Google das noindex dann nicht lesen kann.
Warum steht eine per robots.txt gesperrte Seite trotzdem bei Google?
Die robots.txt verhindert nur das Abrufen, nicht die Aufnahme in den Index. Verlinken andere Seiten auf die URL, kann Google sie ohne Beschreibung anzeigen. Soll sie verschwinden, gibst du die Seite fürs Crawling frei und setzt noindex.
Wie lange dauert es, bis eine neue Produktseite indexiert ist?
Laut Google kann es etwa eine Woche dauern, manchmal auch länger. Mit einer aktuellen Sitemap und interner Verlinkung aus der passenden Kategorie hilfst du Google, die Seite schneller zu finden. Eine Garantie für die Aufnahme gibt es nicht.
Gehören ausverkaufte Produkte in den Index?
Kommt das Produkt wieder, bleibt die Seite indexierbar, idealerweise mit Hinweis auf die Verfügbarkeit oder auf Alternativen. Ist es dauerhaft aus dem Sortiment, liefert die URL 404 oder 410, damit Google sie nicht weiter abruft.
Quellen
- Google: Sichtbarkeit von Inhalten in der Google Suche definieren
- Google: Verwaltung des Crawling-Budgets
- Google: Best Practices für die URL-Struktur für E-Commerce-Websites
- Google: Crawling von Facettensuche-URLs verwalten
- Google: Robots.txt Introduction and Guide
- Google: Aufnahme in den Google-Suchindex mit „noindex“ blockieren
- Google: Sitemap erstellen und einreichen
- Google: Um erneutes Crawlen deiner Website bitten
- Search Console-Hilfe: Bericht zur Seitenindexierung
- Shopify Help Center: Eine Seite vor Suchmaschinen ausblenden
- Google Search Central Blog: URL Parameters Tool eingestellt (2022)
- Google Search Central Blog: Crawling December, Faceted navigation (2024)
- Google: Aktuelle Updates der Search-Dokumentation