Insights · · 9 Min. Lesezeit · HYPED
Crawl Budget im Shop: Wann es zählt und wie du es optimierst
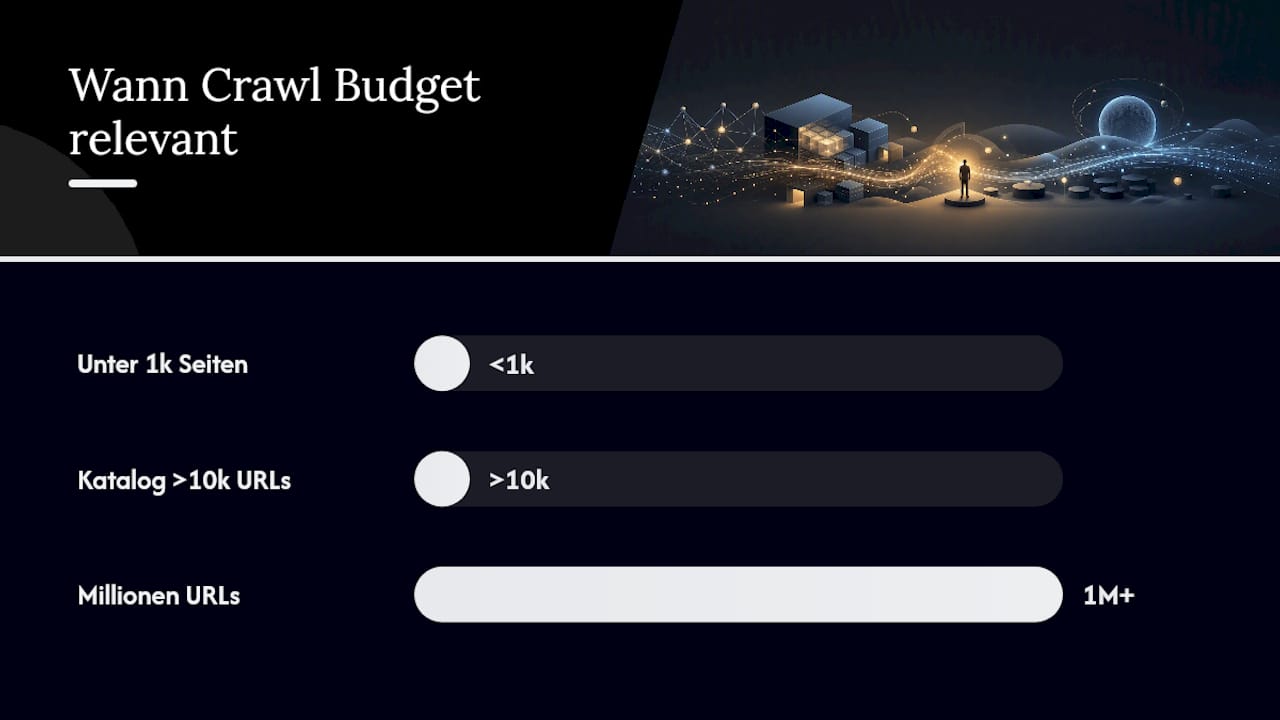
Für die meisten Shops wird das Crawl Budget erst ab rund 10.000 einzigartigen URLs zum limitierenden Faktor. Google definiert es als das Minimum aus Crawl Rate Limit (Serverkapazität) und Crawl Demand (Googles Interesse an deinen Seiten). Betreibst du einen Shop mit facettierter Navigation oder vielen Varianten, solltest du sofort einen Logfile-Export ziehen und robots.txt sowie Sitemap prüfen, bevor du weiterliest.
Kurz gesagt:
- Bei Shops mit mehr als 10.000 einzigartigen URLs, vor allem bei facettierter Navigation und häufigen Produktänderungen, ist das Crawl Budget ein entscheidender Engpass.
- Google bestimmt das Crawl Budget hauptsächlich durch Serverantwortzeiten (TTFB) und die relative Bedeutung der Seiten, wobei eine Server-Antwortzeit unter 200 Millisekunden optimal ist.
- Logfile-Analysen liefern detaillierte Einblicke in die tatsächlichen Crawl-Muster, während die Google Search Console nur aggregierte Daten bereitstellt.
- Besonders vermieden werden sollten Filter-Kombinationen, die aus wenigen Kategorien hunderte fast identische URLs generieren, sowie Redirect-Ketten und große HTML-Seiten.
- Effektive Maßnahmen zur Optimierung sind die Blockierung von Seiten mit Parameter-Explosionen, Canonical- und Redirect-Strategien sowie technische Verbesserungen am Server, wobei Daten vor der Umsetzung essentiell sind.
Inhaltsverzeichnis
- Was Crawl Budget für deinen Shop bedeutet
- Wie Google das Crawl-Budget technisch bestimmt
- Google Search Console oder Logfile-Analyse: Was zeigt wirklich das Budget?
- Die größten Crawl-Budget-Killer in Onlineshops
- Optimierungs-Checkliste für Onlineshops
- Der praktische Audit-Ablauf in fünf Schritten
- Monitoring nach dem Audit: Welche Werte du im Blick behalten musst
- Warum diese Empfehlungen aus der Praxis stammen
- Was beim Crawl Budget wirklich zählt
- Hyped als Sparringspartner für dein Crawl-Budget-Audit
- Quellen
- FAQ
Was Crawl Budget für deinen Shop bedeutet
Crawl Budget ist kein fixer Wert, den Google dir zuweist, sondern das Ergebnis zweier Kräfte, die gegeneinander wirken. Die erste ist der Crawl Rate Limit: Wie viele Anfragen kann dein Server verarbeiten, ohne dass Antwortzeiten explodieren oder Fehler auftreten. Die zweite ist der Crawl Demand: Wie sehr will Googlebot deine Seiten überhaupt besuchen, weil sie sich ändern oder für Nutzer relevant sind.
Ein wichtiges Detail dabei: Jeder Hostname bekommt sein eigenes Budget. Läuft deine Shop-Subdomain für Blog oder Hilfe-Center getrennt von der Haupt-Domain, konkurriert sie nicht direkt um dieselben Ressourcen, wird aber auch separat bewertet.
Für welche Shops wird das Thema konkret relevant?
- Kataloge mit mehr als 10.000 einzigartigen URLs, oft durch Varianten und Filterkombinationen erzeugt
- Facettierte Navigation, die aus einer Kategorie hunderte URL-Permutationen macht
- Shops mit häufigen Preis- oder Lageränderungen, bei denen Aktualität zählt
- Migrationsprojekte mit vielen Redirects und alten URL-Strukturen
Nach Angaben von Google selbst ist Crawl Budget für Websites unter 1.000 Seiten praktisch nie ein Problem. Sobald ein Shop aber facettierte Filter mit Größe, Farbe und Material kombiniert, kann die URL-Zahl schnell ins Millionenfache kippen.
Wie Google das Crawl-Budget technisch bestimmt
Auf der Kapazitätsseite entscheidet vor allem der Hostload: Wie schnell antwortet dein Server (TTFB), und wie stabil bleibt er unter Last. Sinkt die Antwortzeit, drosselt Googlebot automatisch die Crawl-Rate, um deinen Server nicht zu überlasten. Auf der Nachfrageseite zählen Popularität und Qualität. Seiten mit vielen internen und externen Links sowie regelmäßigen inhaltlichen Änderungen werden häufiger besucht als verwaiste Filterseiten ohne Linkstruktur.
Zwei technische Details werden dabei oft unterschätzt:
- DNS-Latenz addiert sich zu jeder einzelnen Anfrage und summiert sich bei Millionen von URLs zu echter Wartezeit
- Große HTML-Pakete verbrauchen mehr Bandbreite pro Crawl-Vorgang und verlangsamen den gesamten Prozess
Kennzahl im Blick: Ein praxisorientierter Guide zur Crawl-Budget-Optimierung nennt einen TTFB von unter etwa 200 Millisekunden als Zielwert, ab dem Server keine spürbare Bremse mehr für das Crawling darstellen. Liegt dein Shop deutlich darüber, verschenkst du Crawl-Kapazität, unabhängig davon, wie gut deine Inhalte sind.
Google Search Console oder Logfile-Analyse: Was zeigt wirklich das Budget?
Beide Quellen sind nötig, aber sie beantworten unterschiedliche Fragen. Die Crawling-Statistiken in der Google Search Console zeigen dir aggregiert Anfragen pro Tag, durchschnittliche Antwortzeiten, die Verteilung der HTTP-Statuscodes und ungefähre Seitengrößen. Das reicht für einen ersten Überblick, verschweigt aber, welche einzelnen URLs wie oft angefragt wurden.
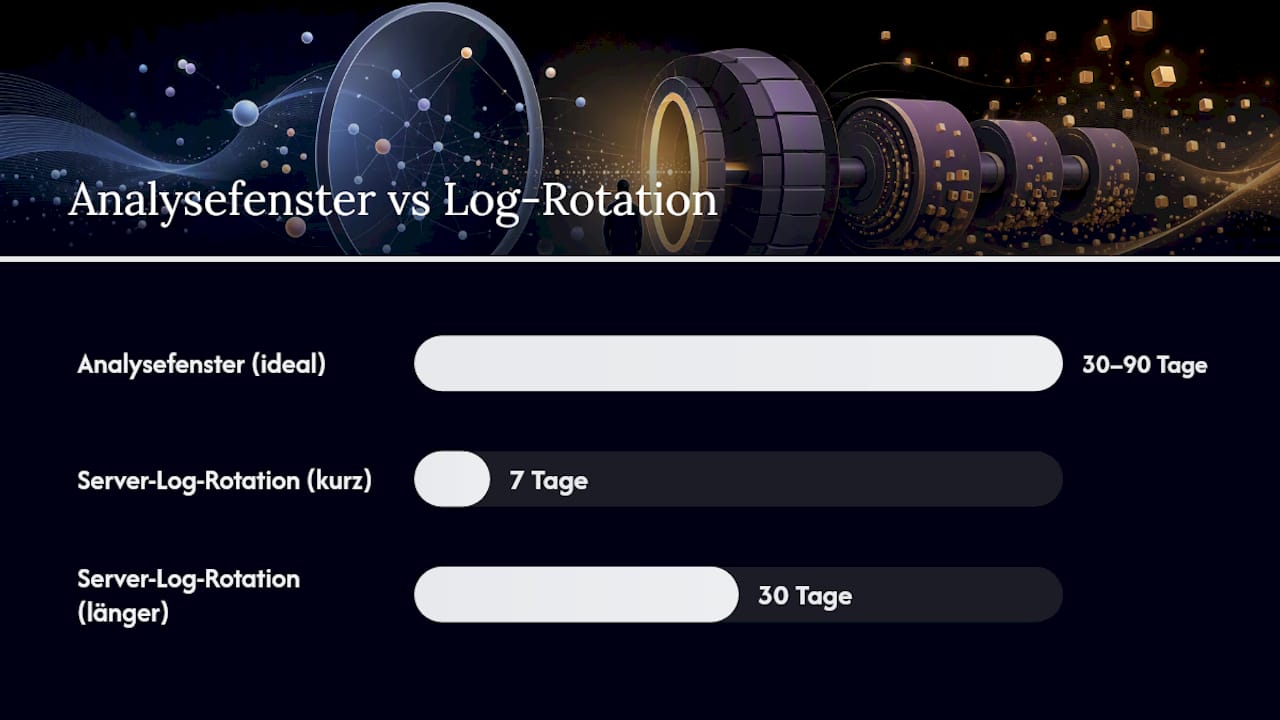
Genau hier kommen Logfiles ins Spiel. Sie protokollieren jede einzelne Anfrage von Googlebot, inklusive Parameterhits, Redirect-Schleifen und Crawls auf Low-Value-Seiten. Nach Erkenntnissen aus der SEO-Praxis ist ein Analysefenster von 30 bis 90 Tagen ideal, um saisonale Muster und wiederkehrende Fehler zuverlässig zu erfassen.
So gehst du praktisch vor:
- Logs vom Server exportieren, idealerweise 90 Tage, gefiltert nach Googlebot-User-Agent
- Requests nach URL-Pfad gruppieren und Häufigkeiten zählen
- Parameter-Hits separat auswerten, um Facetten-Explosionen zu erkennen
- HTTP-Statuscodes pro URL-Gruppe abgleichen, um Fehlerquellen zu lokalisieren
- Ergebnisse mit den GSC-Daten kreuzchecken, um Abweichungen zu erklären
Profi-Tipp: Rotieren deine Server-Logs bereits nach 7 oder 30 Tagen, richte frühzeitig ein Log-Shipping in ein externes System ein. Sonst fehlen dir genau die Daten, die ein belastbares Audit erst möglich machen.
Die größten Crawl-Budget-Killer in Onlineshops
Bestimmte Fehlerbilder ziehen in Shops überproportional viel Budget ab, weil sie sich durch die Kombinatorik von Kategorien und Filtern vervielfachen. Wer priorisiert reparieren will, sollte diese fünf Muster zuerst prüfen.
- Filter- und Facetten-Kombinationen, die aus einer Kategorie hunderte fast identische URLs erzeugen
- Tiefe Paginierung und Archivseiten, die niemand verlinkt und kaum jemand besucht
- Produktvarianten mit fehlerhaften oder fehlenden Canonical-Tags, die Duplicate Content erzeugen
- Redirect-Ketten und Soft-404-Seiten, die Googlebot mehrfach durchläuft, ohne ein Ergebnis zu liefern
- Übergroße HTML-Seiten, bei denen Google laut Faustregel ab etwa 2 MB abbricht und den Rest ignoriert
Ein typisches Beispiel: Ein Shop mit 500 Produkten und drei Filterdimensionen (Farbe, Größe, Material) kann theoretisch über 10.000 URL-Kombinationen erzeugen, obwohl es nur 500 echte Produktseiten gibt. Googlebot verschwendet dann einen Großteil seiner Besuche auf Seiten, die niemand sucht und die kein Ranking-Potenzial haben.
Optimierungs-Checkliste für Onlineshops
Nicht jede Maßnahme muss sofort passieren. Sinnvoll ist eine Staffelung nach Aufwand und Wirkung.
- Sofort: robots.txt bereinigen und Parameter-URLs blockieren, Sitemaps auf indexierungswürdige URLs verkleinern, Low-Value-Seiten wie interne Suchergebnisse auf noindex setzen
- Kurzfristig: eine klare Canonical-Strategie für Variantenseiten etablieren, URL-Parameter-Behandlung in der Search Console konfigurieren, bestehende Redirect-Ketten auf einzelne Sprünge reduzieren
- Langfristig: TTFB und DNS-Antwortzeiten technisch optimieren, ein CDN einsetzen, Seitengrößen durch schlankeres HTML und komprimierte Ressourcen reduzieren, feste Pagination-Regeln definieren
Bei dauerhaft entfernten Produkten lohnt sich der HTTP-Statuscode 410 statt eines einfachen 404, weil er Google eindeutig signalisiert, dass die Seite nicht zurückkommt. Segmentierte Sitemaps nach Kategorie oder URL-Typ helfen zusätzlich, weil sie dir in der Search Console eine granularere Fehlerdiagnose erlauben, statt eine einzige riesige Sitemap-Datei zu verwalten. Wer die technischen Details zu Canonical, Redirects und Pagination vertiefen will, findet dazu weiterführende Hinweise zur technischen SEO-Optimierung im E-Commerce und eine eigene Anleitung zur Pagination-Handhabung.
Profi-Tipp: Setze bei der Priorisierung nicht auf Bauchgefühl. Sortiere deine Fehlerliste nach geschätzter URL-Anzahl mal Crawl-Häufigkeit aus den Logs. Das zeigt objektiv, welcher Fix den größten Hebel hat.
Der praktische Audit-Ablauf in fünf Schritten
- Daten sammeln: Search-Console-Export, 90 Tage Server-Logs, aktuelle Sitemap und robots.txt zusammentragen
- Analysieren: häufig gecrawlte Low-Value-URLs identifizieren, eine Hitliste der problematischsten Parameter erstellen
- Entscheiden: für jede URL-Gruppe festlegen, ob noindex, Blockierung über robots.txt, Canonical oder vollständige Entfernung die richtige Antwort ist
- Umsetzen: einen Deploy-Plan für robots.txt-Änderungen, neue Sitemap, Redirect-Korrekturen und Server-Tuning aufstellen
- Validieren: nach 7 und nach 30 Tagen erneut Logs prüfen und die relevanten Kennzahlen mit dem Ausgangszustand vergleichen
Dieser Ablauf funktioniert nur, wenn Schritt fünf tatsächlich passiert. Viele Teams brechen nach der Umsetzung ab und wissen am Ende nicht, ob die Maßnahmen etwas gebracht haben.
Monitoring nach dem Audit: Welche Werte du im Blick behalten musst
Ein einmaliges Audit hält selten dauerhaft. Neue Filterkombinationen, neue Produktlinien oder ein CMS-Update können alte Probleme zurückbringen.
- Wöchentlich die Crawl-Anfragen, die 4xx- und 5xx-Trends sowie Indexierungsänderungen in der Search Console prüfen
- Monatlich eine Log-Analyse durchführen oder ein automatisiertes Dashboard für die Bot-Verteilung aufsetzen
- Bei sprunghaftem Anstieg von 5xx-Fehlern, einer neuen Parameter-Flut oder verschlechtertem TTFB sofort reagieren, statt bis zum nächsten geplanten Audit zu warten
Warum diese Empfehlungen aus der Praxis stammen
Dieser Leitfaden stammt von Dominic, der bei Hyped seit über zwölf Jahren E-Commerce und seit sieben Jahren Google-Marketing begleitet. Hyped arbeitet dabei als Sparringspartner für Shop-Teams, nicht als klassische Agentur, die Umsetzung übernimmt, sondern als Analyse- und Beratungspartner, der die Prioritäten setzt.
Was beim Crawl Budget wirklich zählt
Die verbreitete Vorstellung, Crawl Budget sei ein Problem für Google-Konzerne mit Millionen Seiten, stimmt so nicht. Ich sehe das bei mittelgroßen Shops mit 15.000 bis 50.000 URLs regelmäßig: Genau dort, wo facettierte Navigation unkontrolliert wächst, wird das Budget zum echten Flaschenhals. Große Enterprise-Shops haben oft schon jemanden, der aufräumt. Der Shop mit 20.000 URLs und einem Zwei-Personen-Marketing-Team hat das meistens nicht.
Was ich an der üblichen Beratung kritisch sehe: Viele Leitfäden empfehlen technische Maßnahmen, ohne vorher zu messen. Robots.txt anpassen, ohne die Logs geprüft zu haben, ist wie ein Medikament verschreiben, ohne die Diagnose zu kennen. Die Reihenfolge muss stimmen, erst Daten, dann Entscheidung, dann Umsetzung.
Priorität eins ist für mich immer die Parameter-Explosion, weil sie meist den größten Anteil an verschwendetem Budget ausmacht und sich mit robots.txt-Regeln vergleichsweise schnell beheben lässt. Server-Tuning kommt danach, weil es länger dauert und mehr Ressourcen braucht.
— Dominic
Hyped als Sparringspartner für dein Crawl-Budget-Audit
Wer die Logfile-Analyse und die Priorisierung nicht selbst stemmen will, findet mit dem HYPED Organic Growth System einen monatlich kündbaren Beratungsrahmen ohne langfristige Vertragsbindung. Statt Umsetzung von außen zu übernehmen, liefert Hyped Audit, Logfile-Auswertung und eine priorisierte Roadmap, die dein Team selbst abarbeitet, oder die als Zweitmeinung neben einer bestehenden Agentur läuft.

Sinnvoll wird das besonders bei komplexen Katalogen über 10.000 URLs, bei Migrationsprojekten mit vielen Redirects oder wenn eine bestehende Agentur Ergebnisse liefert, die sich technisch nicht nachvollziehen lassen. Wer wissen will, was ein solches Paket monatlich kostet und welche Analysen enthalten sind, findet die Details auf der Organic Growth System Seite für 549 € pro Monat. Ein erstes Gespräch zeigt schnell, ob dein Shop tatsächlich ein Crawl-Budget-Problem hat oder ob andere Hebel wichtiger sind.
Quellen
Für tiefere technische Details lohnt der Crawl-Budget-Guide von Google sowie die praxisnahe Anleitung zur Server-Log-File-Analyse. Beide Quellen ergänzen sich gut mit den Crawling-Statistiken der Search Console.
- Crawl Budget Management | Google Crawling Infrastructure | Crawling infrastructure
- Log File Analysis for SEO: Find Crawl Issues & Fix Fast
- Crawl Budget optimieren: der komplette Guide (2026)
FAQ
Ab wann ist Crawl Budget für einen Shop relevant?
Ab etwa 10.000 einzigartigen URLs wird es laut Google relevant, besonders bei facettierter Navigation mit vielen Filterkombinationen.
Reicht die Google Search Console zur Analyse aus?
Nein, die Search Console liefert nur aggregierte Werte. Für einzelne URL-Muster und Parameter-Hits brauchst du eine Logfile-Analyse.
Wie lange sollte das Analysefenster für Logfiles sein?
Empfehlenswert sind 30 bis 90 Tage, weil kürzere Zeiträume saisonale Muster und wiederkehrende Fehler oft nicht vollständig abbilden.
Welche Maßnahme bringt am schnellsten Ergebnisse?
Meist das Bereinigen der robots.txt und das Blockieren von Parameter-URLs, weil Facetten-Explosionen häufig den größten Anteil verschwendeten Budgets ausmachen.
Was kostet eine Crawl-Budget-Beratung bei Hyped?
Das HYPED Organic Growth System kostet 549 € pro Monat, monatlich kündbar, inklusive Audit und individueller Handlungsempfehlungen.